下列生产数字来自 DeepSeek 公开的推理部署 Q&A / 解读文章,描述的是生产推理系统,不是单独安装开源 DeepInfer 的结果。
架构总览
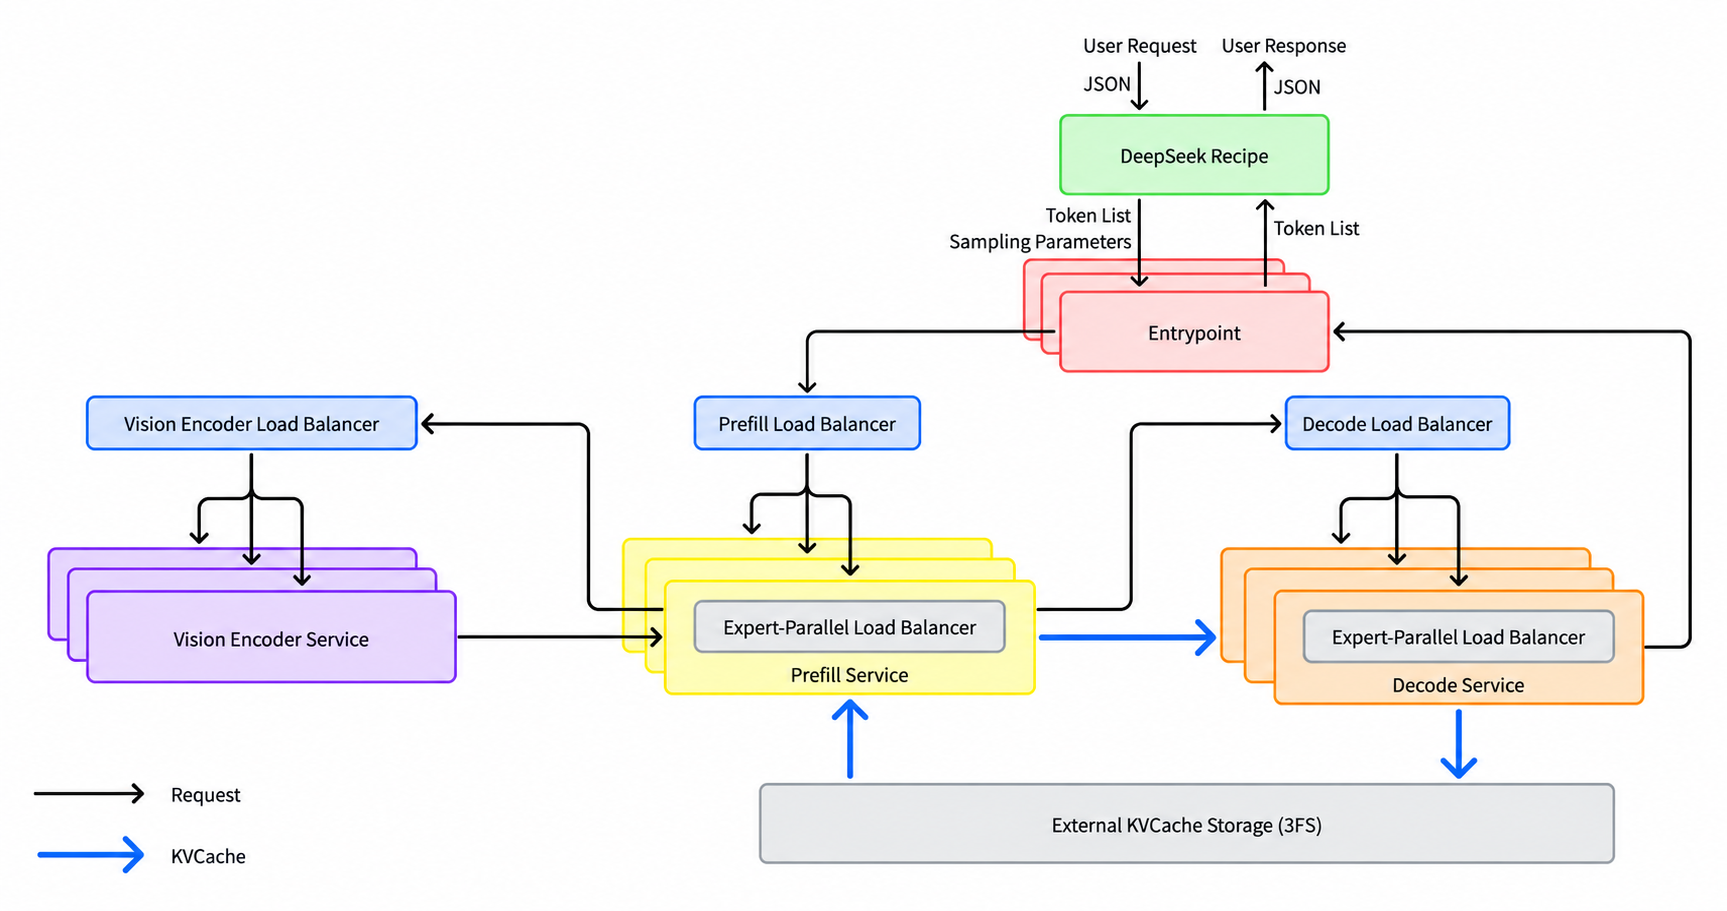 官方架构图 — DeepInfer
doc/images/architecture_overview.png(Apache-2.0)
一次请求如何跑完(概念)
| 步骤 | 组件 | 发生什么 | 开源? |
|---|
| 1 | API / recipe | Messages · Chat Completions · Responses → Conversation → tokens | recipe 为独立 MIT 仓库 |
| 2 | 入口 / 缓存匹配 | 路由前做前缀 / KV 命中长度 | KV 存储未开源 |
| 3 | Prefill 引擎 | 计算未缓存后缀;写入 KV | 引擎有;服务胶水无 |
| 4 | Decode 引擎 | 自回归出 token;Wide-EP MoE | 引擎有;LB/分离无 |
| 5 | 采样 / DSpark | 草稿 + 置信度调度校验 | README 有开关 |
| 6 | recipe 解析 | token 流 → 协议事件(推理 / 工具 / 正文) | recipe 有 |
生产快照(必须标注归属)
| 指标 | 公开数值 | 标注 |
|---|
| 集群 tokens/天 | 约 155 万亿 | 生产系统 |
| 低谷收入 | 约 38 美元 / GPU·小时 | 生产系统 |
| 平均输入 · 缓存命中 | 约 77K · 约 96% | 生产系统 |
| TTFT | 平均约 400 ms | 生产系统 |
| Prefill 无缓存→有缓存 | 约 60k → 约 1.5M tok/s/GPU(约 25×) | 生产系统 |
| Decode · 用户速度 | 约 14k tok/s/GPU · 约 230 tok/s(代码约 300) | 生产系统 |
| 高效单元 | 约 64P + 64D · P:D ≈ 1:1 | 生产 / Q&A |
开源缺口提示
- 开源 DeepInfer:离线引擎 + 算子 + EP/DP/CP 示例
- 未包含:KV cache 系统、完整 PD 分离服务、DP 负载均衡
- 无官方 Docker 镜像 — 社区 Dockerfile 仅为示例
- 今日硬件:SM100(CUDA 13)· 昇腾 950(CANN 9.2)
继续:安装 · 硬件 · 对比 vLLM · recipe · FAQ。
来源:inference_deployment_qa.md · README · 微信公开解读(改写)